AI Ready
Chọn đúng mô hình, phần mềm và cấp hạ tầng cho mục đích AI cụ thể của bạn — rồi chạy trên máy chủ của chính doanh nghiệp, dữ liệu không phải gửi ra ngoài.
Nội dung trung lập về mô hình: gợi ý họ mô hình mở phổ biến, không cam kết điểm số.
Chọn nhu cầu và quy mô để xem lộ trình gợi ý: loại mô hình, phần mềm, cấp hạ tầng và những điểm cần lưu ý trước khi đầu tư.
Chọn một nhu cầu
Nhân viên hỏi quy trình, chính sách, tài liệu kỹ thuật bằng tiếng Việt; AI trả lời kèm trích dẫn đoạn tài liệu gốc.
Máy chủ 2–4 GPU
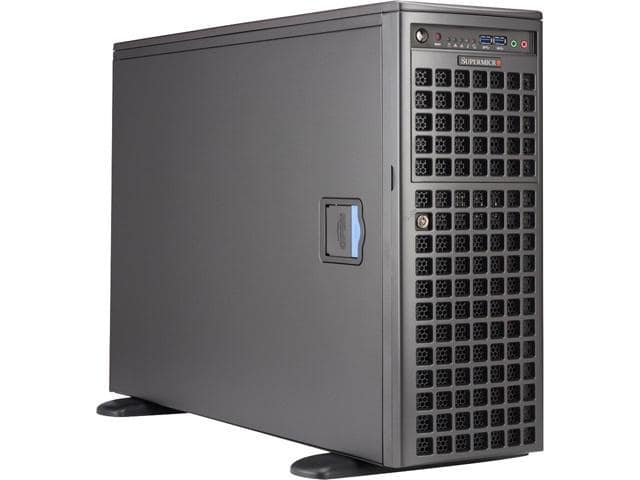
Máy rack trong phòng máy, nguồn và quạt dự phòng, quản trị từ xa. Tách GPU cho LLM và cho embedding/reranker; còn dư chỗ để nâng lên mô hình lớn hơn.
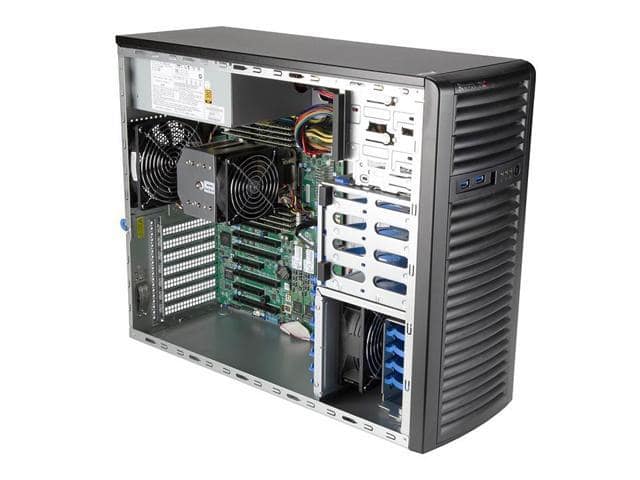
Máy chủ và workstation có GPU lấy trực tiếp từ kho hàng. Chưa chắc cấu hình đủ cho mô hình của bạn? Dùng công cụ tính trước.


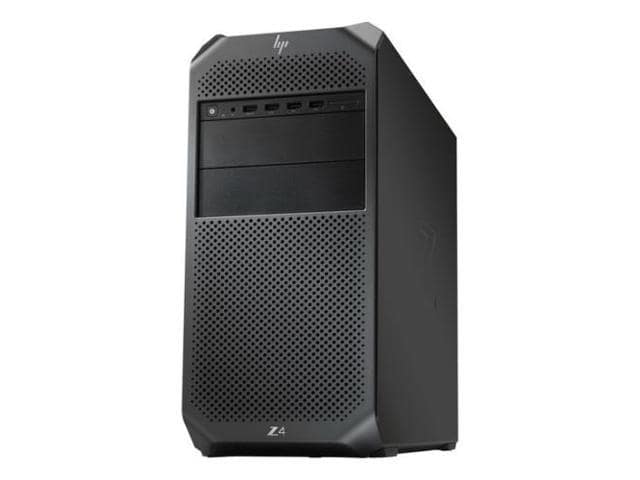
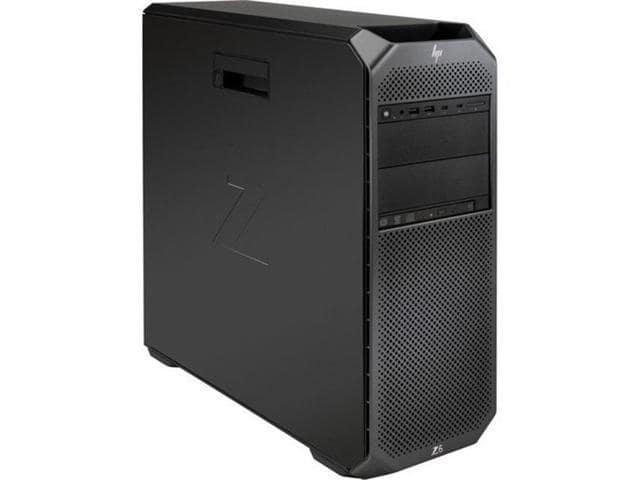
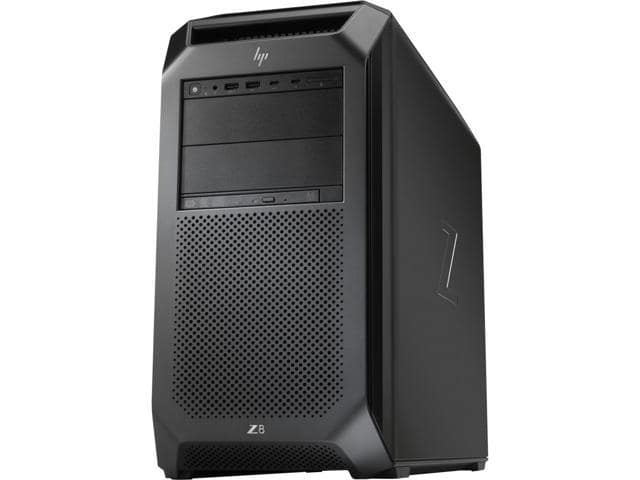
Đọc theo thứ tự của một dự án thật, từ chọn máy tới vận hành.
Không có đáp án chung. Dữ liệu càng nhạy cảm và mức sử dụng càng đều, hạ tầng riêng càng có lý. Nhiều doanh nghiệp chọn kết hợp: thử nghiệm bằng API, đưa việc xử lý dữ liệu mật về máy chủ nội bộ.
| Tiêu chí | On-premise (hạ tầng riêng) | Cloud API |
|---|---|---|
| Bảo mật dữ liệu | On-premiseDữ liệu nằm trong mạng công ty; tự kiểm soát log, phân quyền, nơi lưu trữ. | Cloud APIDữ liệu gửi tới nhà cung cấp; phụ thuộc điều khoản, vị trí máy chủ và cấu hình lưu log của họ. |
| Chi phí khi dùng ít, không đều | On-premiseBất lợi: phần cứng khấu hao cả khi không chạy. | Cloud APICó lợi: trả theo lượng dùng, không đầu tư ban đầu. |
| Chi phí khi dùng nhiều, đều đặn | On-premiseThường có lợi khi GPU được khai thác cao trong nhiều năm. | Cloud APIChi phí tăng tuyến tính theo token hoặc giờ GPU. |
| Tốc độ bắt đầu | On-premiseCần thời gian mua sắm, lắp đặt, cài đặt. | Cloud APIDùng được ngay sau khi có tài khoản. |
| Độ trễ | On-premiseThấp và ổn định trong mạng nội bộ; không phụ thuộc đường truyền quốc tế. | Cloud APIPhụ thuộc Internet và tải của nhà cung cấp; có thể bị giới hạn tốc độ gọi. |
| Tuỳ biến | On-premiseChọn mô hình mở bất kỳ, fine-tune, cố định phiên bản lâu dài. | Cloud APIGiới hạn trong mô hình và tuỳ chọn nhà cung cấp mở; phiên bản có thể bị ngừng. |
| Mô hình mạnh nhất | On-premiseChỉ dùng được mô hình mở trọng số. | Cloud APITiếp cận các mô hình thương mại đóng mới nhất. |
| Vận hành | On-premiseCần người quản trị phần cứng, driver, cập nhật, giám sát (hoặc thuê ngoài). | Cloud APINhà cung cấp lo hạ tầng; doanh nghiệp lo tích hợp và chi phí. |
Gửi mục đích, số người dùng và loại dữ liệu. Kỹ sư HQG đề xuất cấu hình, phần mềm và phương án triển khai phù hợp.