Nhúng & rerank (RAG)Dùng thương mại được
Qwen3-Embedding-8B: cần bao nhiêu VRAM, GPU nào để chạy
Alibaba Qwen phát hành Qwen3-Embedding-8B với 7,6 tỷ tham số. Bảng dưới ước tính bộ nhớ GPU cho từng cách dùng để bạn chọn đúng máy chủ trước khi đầu tư. Mô hình nhúng xử lý từng lượt, không giữ KV cache như chatbot; bộ nhớ tăng theo độ dài × batch khi vector hoá.
Thông số
- Hãng phát triển
- Alibaba Qwen
- Họ mô hình
- Qwen3
- Nhóm
- Nhúng & rerank (RAG)
- Số tham số
- 7,6 tỷ tham số
- Ngữ cảnh gốc
- 32.768 token
- Giấy phép
- Apache 2.0 — dùng thương mại được
- Tiếng Việt
- Hãng chưa công bố cụ thể
- Ứng dụng gợi ý
- Vector hoá tài liệu dài · Tìm kiếm đa ngôn ngữ · Phân cụm văn bản
VRAM ước tính theo độ chính xác
Chỉ gồm trọng số, gradient/optimizer (khi huấn luyện) và dự phòng — bộ nhớ theo độ phân giải ảnh, độ dài audio hay batch cần đo thực tế. Đã gồm dự phòng CUDA/framework.
| Tác vụ | FP32 | BF16 | FP8 / INT8 | INT4 |
|---|---|---|---|---|
| Suy luận (1 người dùng) | 34,1 GB | 17,5 GB | 9,1 GB | 5,4 GB |
| Fine-tune LoRA | — | 18,8 GB | 10,5 GB | — |
| Fine-tune QLoRA | — | — | — | 6,4 GB |
| Fine-tune toàn phần | 140,1 GB | 140,1 GB | — | — |
"—" là tổ hợp không dùng trong thực tế. GB = 10⁹ byte; VRAM hãng ghi theo GiB nên card thực tế dư thêm khoảng 7%.
Phương án GPU gợi ý
Số card ít nhất đủ VRAM, ưu tiên cân bằng giữa số lượng, độ dư bộ nhớ và giá card.
- Suy luận 4-bitcần ~5,4 GB
1 × NVIDIA L4 24GB · 24 GB · ~94 W · card ~68.500.000 ₫
Một card là đủ — đơn giản nhất để triển khai.
Tính với nhiều người dùng / context dài hơn - Suy luận BF16 (chất lượng gốc)cần ~17,5 GB
1 × NVIDIA L4 24GB · 24 GB · ~94 W · card ~68.500.000 ₫
Một card là đủ — đơn giản nhất để triển khai.
Tính với nhiều người dùng / context dài hơn - Fine-tune QLoRAcần ~6,4 GB
1 × NVIDIA L40S 48GB · 48 GB · ~455 W · card ~168.000.000 ₫
Một card là đủ — đơn giản nhất để triển khai.
Tính với nhiều người dùng / context dài hơn
Giá là giá tham khảo riêng card GPU, chưa gồm máy chủ và VAT.
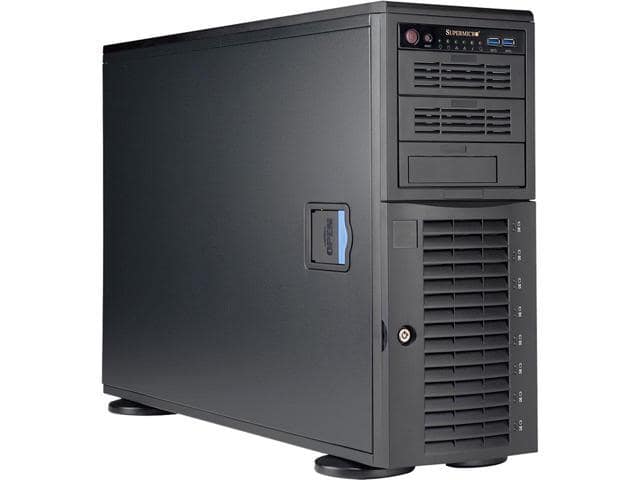
Máy chủ HQG chạy được Qwen3-Embedding-8B
Máy hỗ trợ từ 1 GPU trở lên — đủ khe cho phương án suy luận BF16 ở trên. Cấu hình GPU cụ thể do kỹ sư HQG tư vấn.
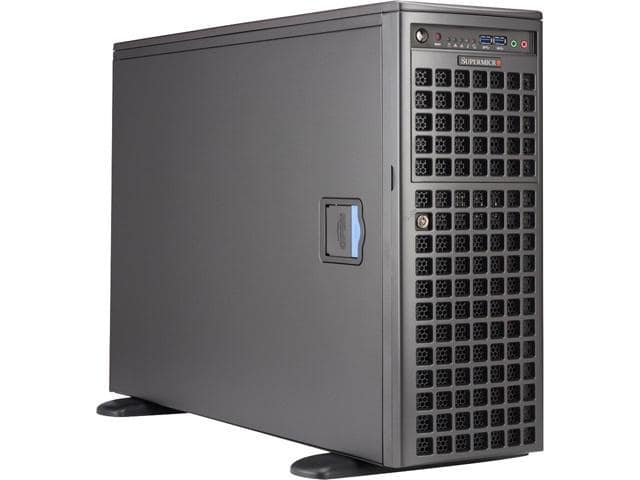
AI Ready
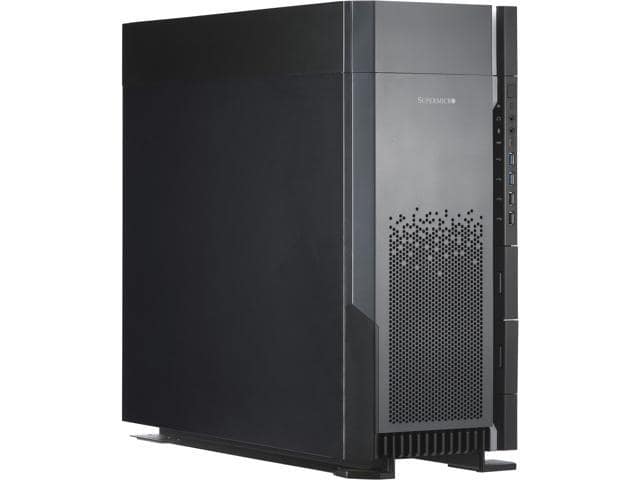
Cần triển khai Qwen3-Embedding-8B cho doanh nghiệp?
HQG tư vấn cấu hình, lắp đặt máy chủ GPU và cài sẵn môi trường chạy mô hình tại hạ tầng của bạn.
Thông tin tham khảo, kiểm tra giấy phép trước khi dùng thương mại. Số tham số và kiến trúc lấy từ trang chính chủ; mức VRAM là ước tính theo công thức, không phải đo thực tế. Dữ liệu cập nhật 09/2026. Nguồn: huggingface.co/Qwen/Qwen3-Embedding-8B.